Токены обсуждают чаще, чем погоду. Их покупают и продают, спорят об их цене, дарят и даже воруют. Постепенно складывается картина: токены — что-то вроде денег для расчётов с нейросетями.
Курса на бирже у них нет, и обменников тоже. Токен — это техническая сущность, кусочек текста: на такие кусочки нейросеть режет всё, что читает или пишет. К деньгам токен причастен лишь в той мере, что сервисы выставляют счёт за количество этих кусочков.
Токены в нейросетях: кусочки текста
Моделям удобнее оперировать частями слов. Чтобы понять вопрос пользователя, обдумать его или дать ответ — языковая модель обрабатывает текст по кусочкам и использует эти кусочки как детали конструктора.
Токены (tokens) — это и есть кусочки слов.
В ходе работы система подсчитывает количество обработанных токенов, чтобы учесть свои «затраты».
Принцип нарезки текста на токены у каждой модели свой, но основных правил — четыре:
часто встречающиеся слова обычно занимают один токен;
редкие слова могут разбиваться на части;
знаки препинания тоже считаются токенами;
числа могут быть как одним токеном, так и несколькими (например, номер года запишется в один-два токена, а длинный номер телефона разобьётся на более мелкие кусочки).
Разберёмся, откуда берутся токены, сколько они стоят и почему кончаются. Выясним, что видно в контекстном окне и как не дать чат-боту потерять нить разговора. Ответы на частые вопросы — по ходу текста, лайфхаки — в конце.
Три письма и два выдуманных навыка
Выдумаем Марину. Ей тридцать четыре, она отличный менеджер по продажам, но ей стало тесно в прежней компании — и она ищет новую работу.
Вакансии есть, но на каждую вакансию надо составить уникальное сопроводительное письмо. Выдумаем для Марины чат-бота: его сделали в компании Plankton AI Labs, он работает на модели ShrimpPro (КреветкаПро).
У «КреветкиПро» два тарифа:
платный тариф: входящие токены — 1 копейка за 100, исходящие токены — 5 копеек за 100;
бесплатный тариф: лимит 5 000 токенов на 2 часа на аккаунт.
Марина открыла чат-бот ShrimpPro и взялась за работу. В первом промпте она просит модель писать коротко, без клише и только по фактам из резюме.
Первые два письма получились отличными, а в третьем бот начал писать помпезно, со штампами — и почему-то приписал Марине навык SQL и права категории CE, которых у неё нет и никогда не было. «Я ЖЕ ПРОСИЛА КОРОТКО И ПО ФАКТАМ!» — капслоком пишет Марина. Бот извиняется, сокращает письмо, но выдумки остаются.
Бот не стал глупее и не перегорел. Всё дело в токенах, в контекстном окне и в других технических сущностях. Слова непривычные, но идея довольно простая.
Сколько токенов в тексте
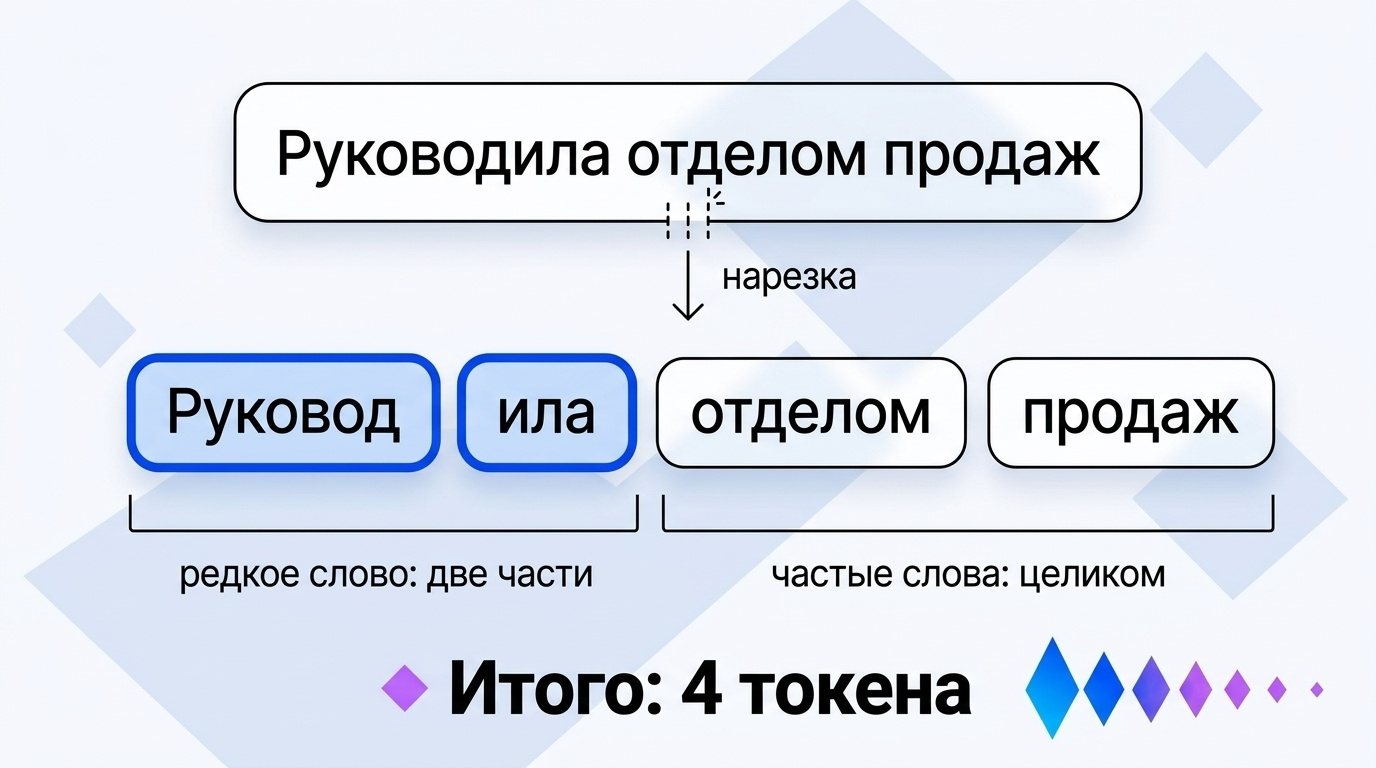
Строчка из резюме Марины «Руководила отделом продаж» нарежется на токены примерно так: Руковод | ила | отделом | продаж. Три слова, четыре токена.
Слова «отделом» и «продаж» встречаются часто и остались целыми, а «руководила» попадается реже, поэтому слово разрезано на две части.
Если считать в токенах, то русский текст обходится дороже английского: русское слово занимает в среднем два-три токена, английское — один-полтора.
FAQ: сколько токенов в странице?
Стандартная страница — это 1 800 знаков с пробелами, примерно 250–300 слов.
Страница русского текста нарежется примерно на 500–750 токенов, английского — на 300–450.
Цифры приблизительные, разные модели нарезают текст по-разному.
Как модель читает токены
У модели есть собственный словарь, в котором хранится полный список известных ей токенов. Полученный текст режется на кусочки, соответствующие токенам из этого словаря. Какое-нибудь редкое слово может делиться на совсем мелкие части, вплоть до отдельных букв. Получившиеся токены модель превращает в набор чисел — вектор. Дальше она работает не с буквами, а с цепочкой этих числовых векторов.
Смысл запроса модель определяет по соседствующим токенам: по тому, какие токены стоят рядом в получившейся цепочке. Токен «ила» сам по себе почти ничего не значит. Но модель прочитала горы текстов и усвоила, что «Руковод» + «ила» дают глагол «руководила» в прошедшем времени и в женском роде. Ага, речь идёт об управлении, но не сейчас, а в прошлом. Следом — токен «отделом»: получается управление подразделением.
FAQ: значит, модель не понимает слов?
Споры об этом идут давно и пока не закончились. Нарезка на токены ничего не доказывает: человек тоже складывает слова из букв и звуков. Смысл модель собирает из контекста — учитывает все токены в окне, а не только соседние.
Для практики важно другое: модель ведёт себя так, будто всё понимает, но при нехватке данных самоуверенно несёт чушь.
Во что обходятся токены
Токены придуманы для решения технических задач, но они служат и для расчёта оплаты — так же, как такси учитывают километры, а грузчики — номер этажа, на который надо затащить рояль. Километры и этажи — это не деньги, но мера выполненной работы. То же и с токенами.
Сервисы считают токены:
на входе (input) — всё, что отправлено боту, например, текст вопроса и приложенные файлы,
на выходе (output) — всё, что бот написал в ответ.
Output-токены стоят дороже, чем input. Платный тариф нашей выдуманной модели ShrimpPro обходится в 1 копейку за 100 токенов на входе и 5 копеек за 100 на выходе. Цены тоже выдуманы, но разница цен за вход и выход в несколько раз — обычное дело и для реальных моделей.
FAQ: почему ответ дороже вопроса?
Модель читает вопрос целиком, за один заход, а ответ составляет последовательно, добавляя к ответу по одному токену, и каждый новый токен в ответе требует отдельного расчёта.
Отсюда наценка: у выдуманной ShrimpPro — пятикратная, а у настоящих сервисов — своя, но тоже заметная.
По той же логике токены подсчитываются и на бесплатных тарифах, где количество доступных токенов лимитировано.
FAQ: так зачем же воровать токены, если это просто оцифрованные кусочки слов?
Воруют не токены, а возможность бесплатно пользоваться чужими токенами в какой-нибудь системе.
Когда вы разберётесь, что такое токены — посмотрите, как их экономить. Этот вопрос довольно подробно описан в другой нашей статье: Экономия токенов при работе с ИИ
Рыбка Дори
Есть очень важная, но неочевидная деталь: у модели вообще нет памяти.
Как рыбка Дори из мультика не помнит, что было минуту назад, так и модель не имеет понятия о том, что она ответила на ваш предыдущий вопрос. Для модели каждый ваш вопрос — первый и единственный: получила вопрос → ответила → забыла.
«Под капотом» ваша переписка с моделью выглядит так: в каждом следующем промпте к вашему очередному вопросу добавляется вся переписка, которую вы вели в текущем чате. В окне чата всё выглядит как обычный обмен репликами, но фактически модель каждый раз читает всю переписку, начиная с первой строки.
Поэтому каждый следующий промпт дороже предыдущего. Допустим, запрос Марины + резюме — 1 000 токенов, каждая вакансия — по 600, а каждый ответ модели — 400 токенов. Марина последовательно отправляет чат-боту ShrimpPro три вакансии с просьбой составить сопроводительное письмо для ответа на вакансию. Платный тариф посчитает эти запросы так:
Шаг 1. Промпт на вход: задание, резюме и первая вакансия (1 600 токенов),
выход — ответ модели №1 (400 токенов);
Шаг 2. Промпт на вход: всё из шага 1 (2 000 токенов), вторая вакансия (600 токенов),
выход — ответ модели №2 (400 токенов);
Шаг 3. Промпт на вход: всё из шагов 1 и 2 (3 000 токенов), третья вакансия (600 токенов)
выход — ответ модели №3 (400 токенов).
Итого: задано три вопроса общим «весом» 2 800 токенов, получено три ответа на 1 200 токенов в сумме, но списано будет не 2 800+1 200, а 9 000 токенов.
Чек растёт с каждым шагом: 0,36 ₽ на первом шаге, 0,56 ₽ — на третьем
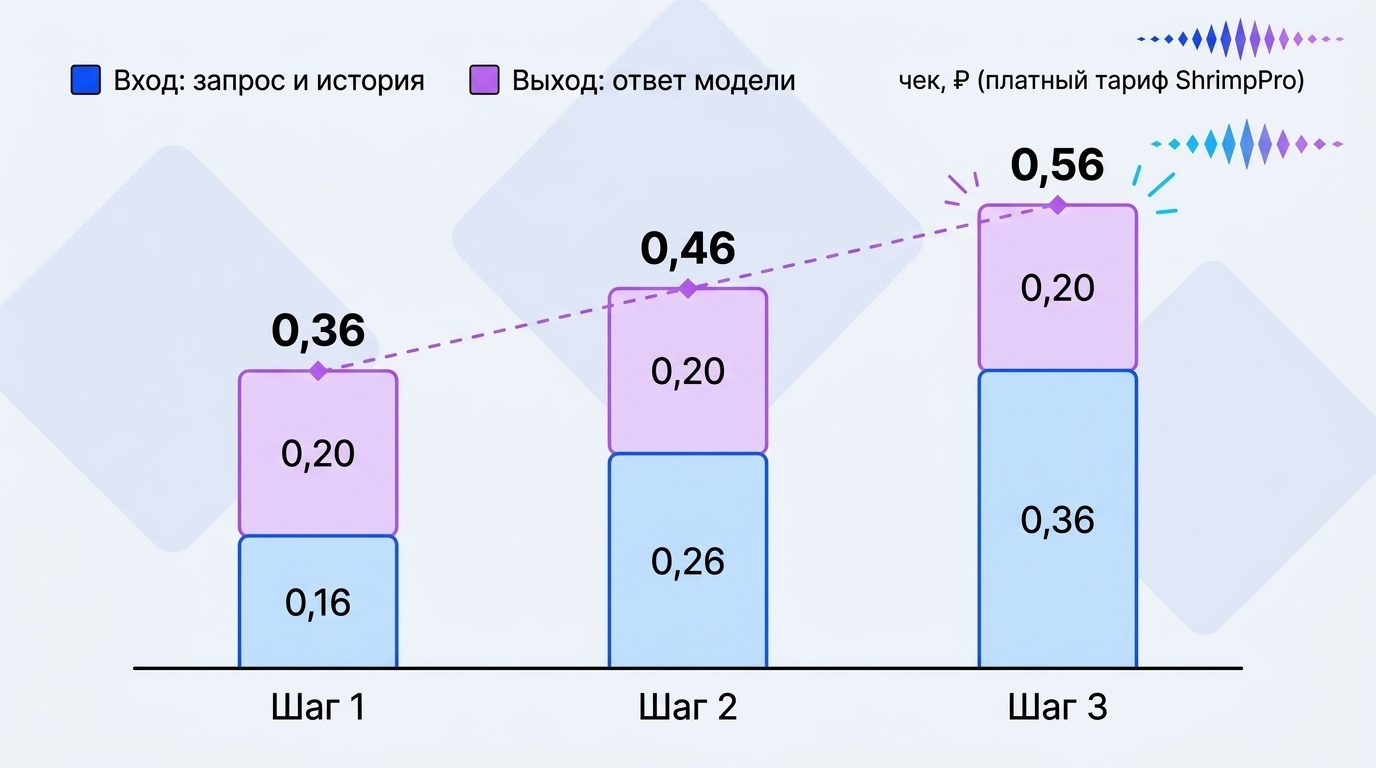
Всего вышло 1,38 ₽: 0,78 ₽ за вход (7 800 токенов) и 0,60 ₽ за ответы (1 200 токенов). Каждый следующий запрос дороже предыдущего: он тянет за собой весь хвост переписки. Те же три ответа в трёх отдельных чатах, с памяткой и текстом вакансии в каждом, обошлись бы в 1,08 ₽, то есть примерно на 22% дешевле.
FAQ: почему бесплатный лимит кончается быстрее, чем ожидалось?
Сервис учитывает все токены, которые идут на вход модели — в том числе и историю чата. Длинная переписка быстро съедает лимиты. Переход в новый чат позволит расходовать токены экономнее.
Контекстное окно: рабочая память чата
За один раз модель способна прочитать весьма большой, но всё же ограниченный объём текста. Этот объём называется окном контекста (context window).
У современных моделей окно контекста может составлять от десятков тысяч до миллионов токенов.
С каждым сообщением история чата нарастает и в один прекрасный момент становится больше контекстного окна. В этом случае модель начинает «забывать» самые старые сообщения: они просто выбрасываются из истории чата.
Когда история длиннее контекстного окна — старые сообщения уходят за его край.
Старые сообщения выше, новые — ниже.
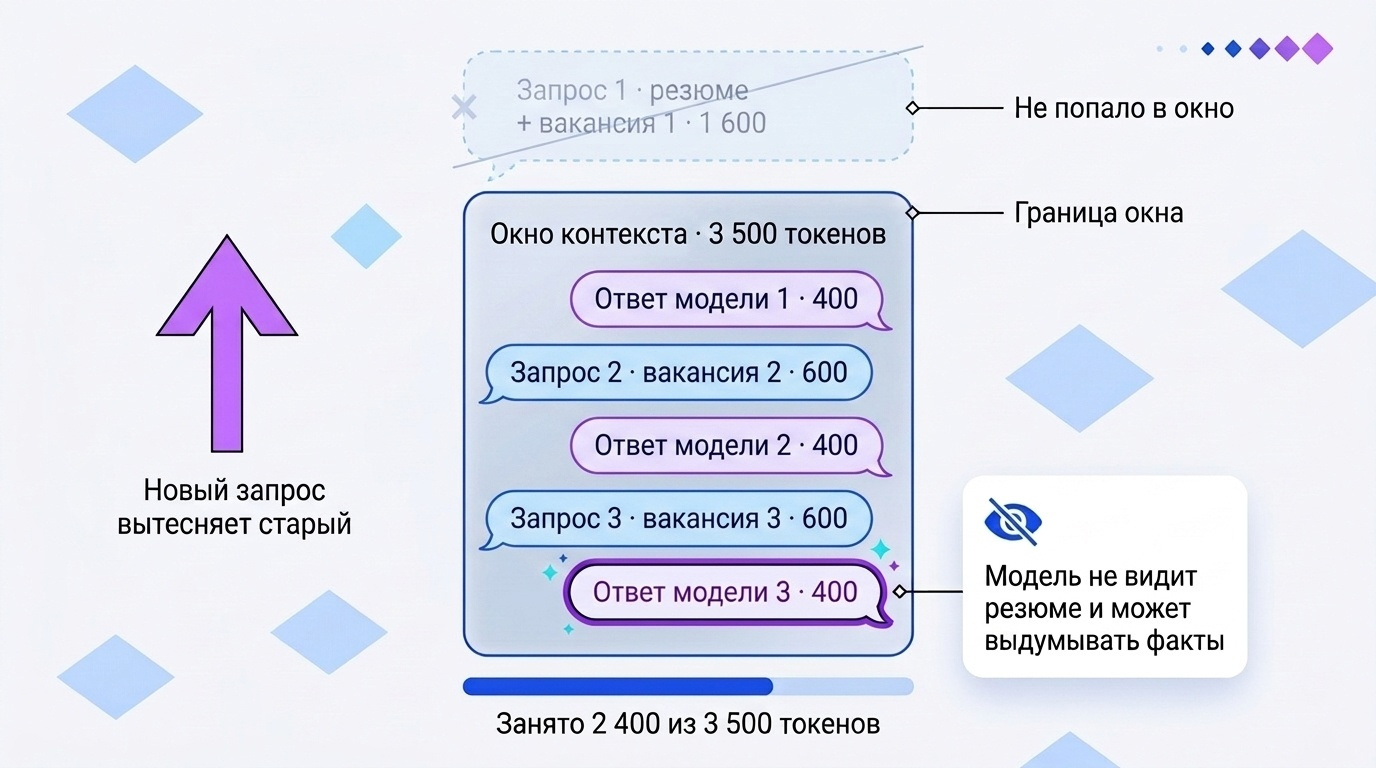
Марина продолжает работу с ShrimpPro. Контекстное окно у этой модели — 3 500 токенов, около шести страниц русского текста.
Два первых промпта с ответами благополучно поместились в окно: вся переписка «весит» 3 000 токенов.
Третий промпт добавляет 600 токенов, на ответ требуется ещё 400. Вся переписка займёт 4 000 токенов, а в контекстное окно помещается 3 500. Хьюстон, у нас проблемы: контекстное окно переполнено.
Но даже в такой ситуации чат-бот обязан отправить ответ. И бот, никого не предупредив, освобождает часть контекстного окна: стирает сообщения из начала диалога, чтобы освободить место для ответа.
Первое сообщение Марины пропадёт целиком: из истории диалога будут удалены и постановка задачи, и резюме, и содержимое первой вакансии.
И очередное сопроводительное письмо модель уже напишет наугад, не основываясь на резюме.
Шаг | Что на входе | Вход, токенов | Выход (ответ модели), токенов | Чек, ₽ |
|---|---|---|---|---|
1 | описание задачи + резюме + вакансия 1 | 1 600 | 400 | 0,36 |
2 | всё прежнее + ответ модели 1 + вакансия 2 | 1 600 + 1 000 = 2 600 | 400 | 0,46 |
3 | всё прежнее + ответ модели 2 + вакансия 3, но без первого сообщения | 1 600 1 000 + 1 000 = 2 000 | 400 | 0,40 |
Итого | 6 200 × 0,0001 = 0,62 ₽ | 1 200 × 0,0005 = 0,60 ₽ | 0,62 + 0,60 = 1,22 |
На третьем запросе входящих токенов стало меньше (2 000 вместо 3 600), и, соответственно, уменьшилась стоимость промпта: 0,40 ₽ вместо 0,56 ₽.
Ура, подешевело. Однако результат работы чат-бота стал заметно хуже, и радоваться особо нечему.
Чек растёт на двух промптах подряд, а потом падает: историю укоротили, токенов на вход стало меньше.
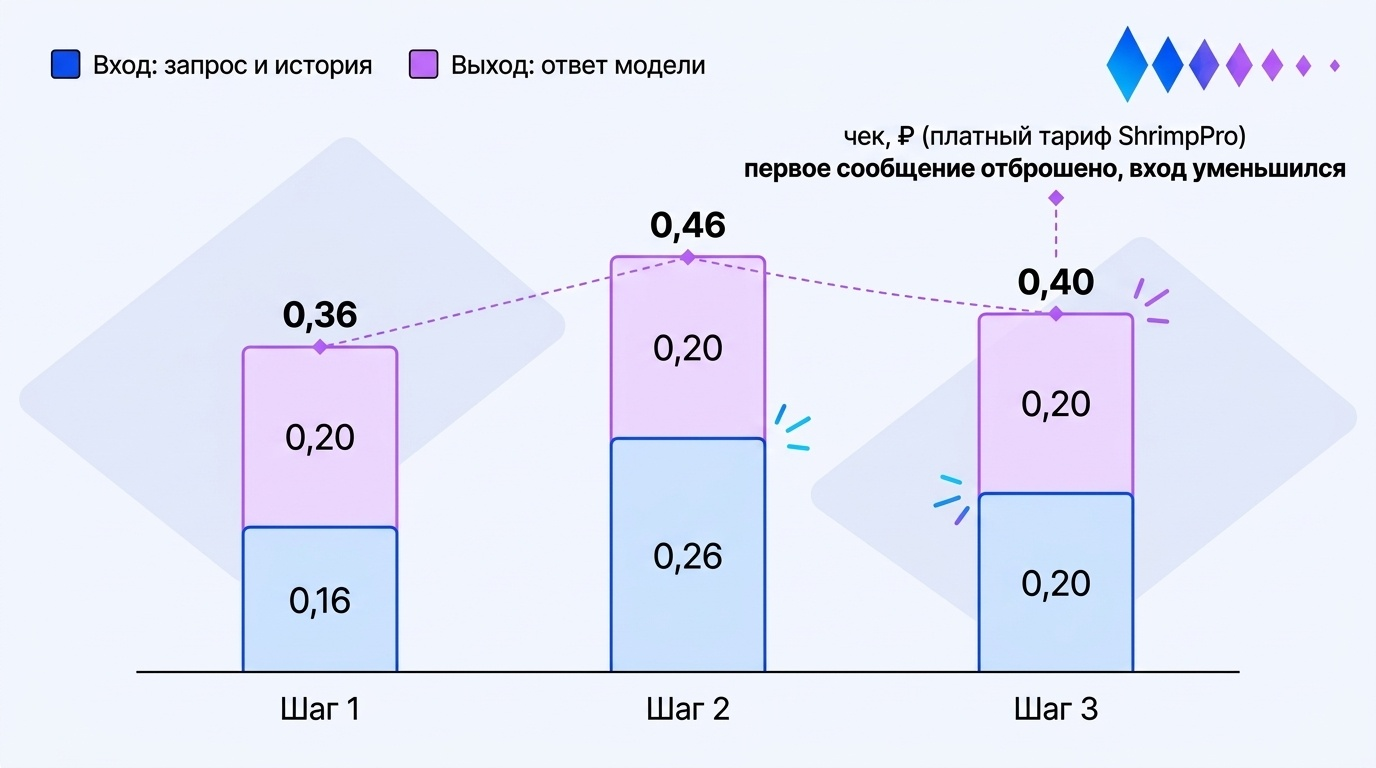
О том, что начало чата потерялось, бот даже не знает: он честно читает то, что ему отправили, а признаков пропажи в запросе нет.
От чат-бота требуют обработать факты из резюме, но резюме вылетело за пределы контекстного окна — и бот начинает фантазировать. Так появляются «галлюцинации» — фантазии вместо фактов.
Недостаток информации бот восполняет правдоподобной выдумкой. Для менеджера по продажам навык SQL вполне реален, почему бы его и не вписать, решает модель. Заодно в письме появляются права категории CE, награда «Лучший менеджер года» и рекорд по продажам холодильников в Антарктиде.
Бот ведёт себя как рыбка Дори из мультика: видит лишь то, что перед носом, выдумывает то, о чём забыл — и уверенно плывёт дальше.
Проблему с переполнение контекстного окна можно решить и другим способом. Современные приложения научились сжимать контекст (compaction): модель сама для себя делает короткий пересказ переписки и подставляет конспект на место оригинала. Задача и ключевые моменты истории переписки остаются в окне контекста, пусть и в сжатом виде.
Сжатие контекста — это обычный запрос к модели, что-то вроде «выбери самое важное из переписки, а остальное удали», но этот запрос выполняется автоматически, без вашего участия — и тратит ваш лимит или баланс.
Если бы ShrimpPro сжала 3 000 токенов истории в конспект на 300 токенов, это стоило бы около 0,45 ₽. Кроме того, в конспекте теряются детали: точные цифры, формулировки, запреты вроде «не выдумывай факты». А потерянную деталь модель восполнит правдоподобной выдумкой.
FAQ: почему приложения не сжимают историю при каждом сообщении?
Сжатие стоит денег и времени, а конспект неизбежно теряет детали переписки. Поэтому сжатие запускают, когда окно почти заполнено. После нескольких сжатий подряд от исходных формулировок мало что остаётся.
FAQ: почему бот не скажет «я не вижу начала разговора»?
Он бы и рад, но он просто не знает, что там что-то было. Некоторые сервисы предупреждают о переполнении окна, но рассчитывать на это не стоит.
Странное поведение бота перестаёт быть загадкой, когда понимаешь, что происходит у него «в голове». После чтения статьи приходите на бесплатный курс Хекслета «Основы ИИ». Программа рассчитана на начинающих пользователей. Вы глубже разберётесь в устройстве языковых моделей и в нюансах работы с ними. Курс ведёт студента от общего представления о языковых моделях к промпт-инжинирингу. Лучшее время, чтобы начать — это сейчас.
Когда пора в новый чат
У раздутого чата есть узнаваемые симптомы:
ответы стали длиннее, суше или более шаблонными, чем в начале;
бот перестал соблюдать условия, которые раньше выполнял;
в тексте появились детали, которых нет в исходных данных;
диалог с ботом содержит десятки сообщений большого объёма.
Если симптомы налицо, можно проверить напрямую: спросить «Перечисли условия и требования, которые ты сейчас учитываешь». Если в ответе нет тех правил, которые вы указали в стартовом промпте — скорее всего, начало чата уже вылетело за контекстное окно.
И это значит, что пора переносить обсуждение в новый чат.
Переносить всю историю не нужно: потребуйте, чтобы чат-бот создал для вас памятку с сутью разговора. Это похоже на автоматическое сжатие контекста, только вы делаете его сами и сами же решаете, что в нём сохранить.
Набор лайфхаков для любого чат-бота
Формулируйте точно и просите бота задавать вопросы.
Точные формулировки работают лучше намёков. Добавьте в первое сообщение: «Прежде чем отвечать, задай мне пять вопросов». Бот уточнит тон, факты и формат, и переделок станет меньше.
Не перекармливайте бота информацией.
Уберите из запроса то, что не нужно для решения задачи: длинные предыстории, повторы, посторонние детали. Лишний текст стоит денег и повышает риск, что важная информация вылетит из окна.
Ограничивайте ответ прямо в запросе.
Токен на выходе дороже токена на входе, а боты до смешного многословны. Опишите формат и длину ответа: «Ответ в виде списка, без вступлений вроде „Конечно!“, без пояснений после ответа. Объём — не более 400 знаков с пробелами». Расход токенов на выходе уменьшится.
Редактируйте запросы.
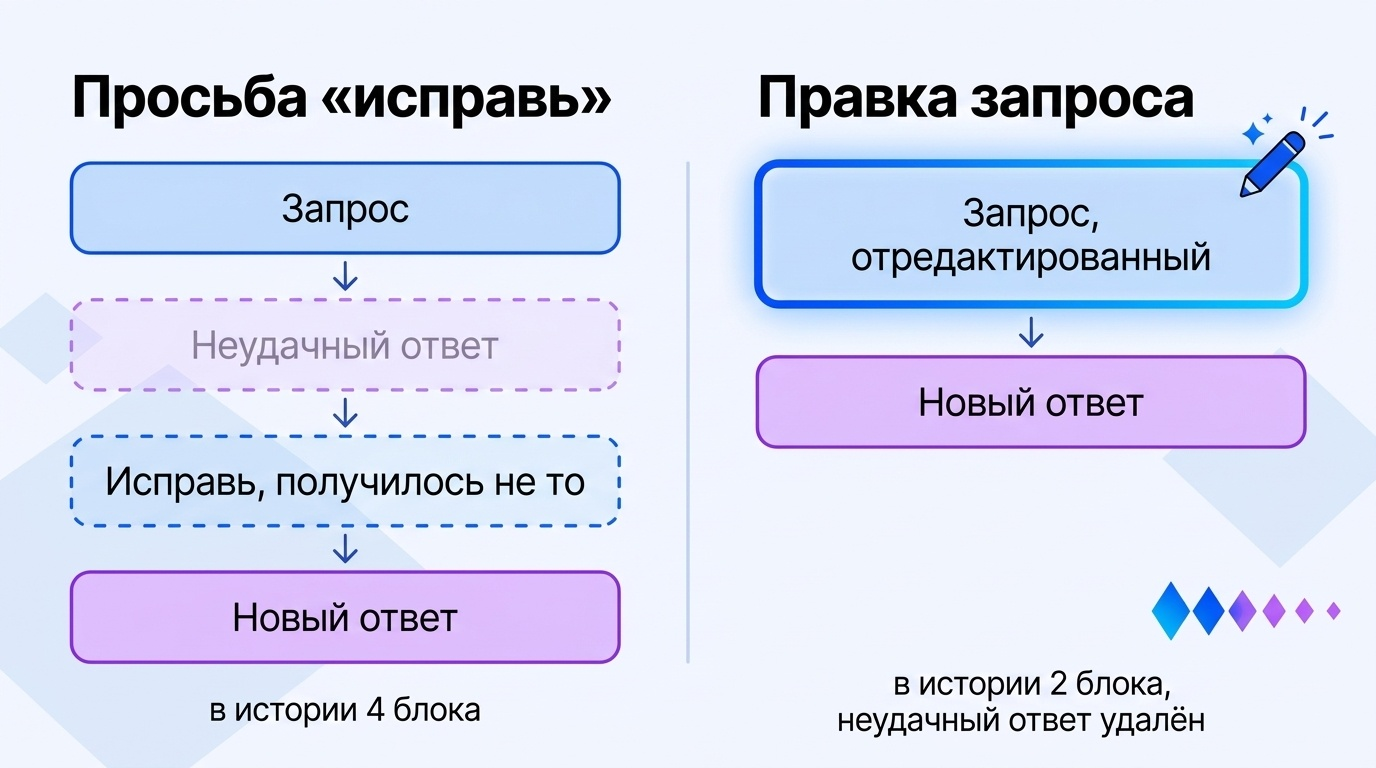
Если ответ чат-бота вас не устраивает — отредактируйте отправленный запрос: в большинстве чат-приложений возле запроса есть кнопка «Редактировать». Неудачный ответ удалится из истории, не раздует все следующие запросы и не займёт место в окне контекста. Это выгоднее, чем отправлять новый промпт с требованием «Исправь свой предыдущий ответ».
При редактировании промпта неудачный ответ удаляется из истории и не раздувает её
Одна задача — один чат.
Каждое новое сообщение тянет за собой весь хвост переписки. Чем длиннее чат, тем дороже запросы. Для новой задачи открывайте новый чат. Переносите в него памятку, сделанную по запросу вроде такого: «Подготовь памятку для переноса в новый чат: коротко опиши задачу, условия, исходные данные и то, что уже сделано по задаче». Это сжатие контекста, которое вы делаете сами. Главное — успеть до того, как бот начнёт галлюцинировать.
Напоминайте о главном.
Условия, важные для ответа, дублируйте в начале новых сообщений: «Опирайся только на мои данные. Не выдумывай факты». Так требования остаются в хвосте переписки и не вылетают из окна контекста.
Проверяйте ответы.
Всегда сверяйте результат с исходными данными, особенно цифры, имена и факты.
Вам телеграмма
При отправке телеграмм оплачивается каждое слово, поэтому телеграммы всегда лаконичны: «ЗНАЮ ЗПТ ЧТО ТАКОЕ ТОКЕНЫ ТЧК ЧИТАЙ СТАТЬЮ ВСКЛ ВСКЛ». Точно так же оплачиваются и токены.
Телеграмма для Марины:
«УСТАНОВИ ФОРМАТ И ДЛИНУ ОТВЕТА ЗПТ ЗАПРЕТИ ВЫДУМКИ ТЧК СНАЧАЛА ВОПРОСЫ ЗПТ ПОТОМ ВЫПОЛНЕНИЕ ТЧК ЗАВЕДИ ПАМЯТКУ ТЧК НОВАЯ ЗАДАЧА НОВЫЙ ЧАТ ВСКЛ»
Теперь, когда вы немного разобрались с вопросом «Что такое токены и зачем они мне?» — можно посмотреть, а что там дальше, в этой кроличьей норе. У Хекслета есть учебный курс «Вайб-кодинг на Claude Code», где вы получите и теорию, и практические навыки: научитесь создавать приложения и автоматизировать рутину с помощью ИИ. Опыт в программировании не нужен, достаточно здравого ума и логики.
Названия компании и модели, цены, размер окна и лимиты, менеджер Марина и все её промпты вымышлены, все совпадения случайны. Ни один ИИ не пострадал.