Работа с ИИ-чатами уже несколько лет как стала бытовым навыком: с вопросами к нейросети приходят филологи, бухгалтеры, учителя, строители. И чем больше не-айтишник общается с нейросетью — тем большего ему хочется (и всё большего — не хочется).
Хочется: конфиденциальности, больших лимитов, постоянной доступности.
Не хочется: платить, колдовать над доступами к сервису, изучать технические детали нейросети.
Локальную нейросеть можно поставить на домашний ноутбук — и работать, не заботясь о тарифах, блокировках аккаунтов или о доступности серверов производителя.
Три основных шага, которые понятны обычному пользователю:
Проверить, справится ли компьютер: RAM от 16 ГБ, видеокарта от 8 ГБ или встроенная, процессор с AVX2.
Скачать и поставить программу LM Studio.
Скачать модель.
Готово, можно работать.
Это удобно. Но в инструкциях по установке — терминологический зоопарк.
— Квантование — это что-то из физики? Эмбеддинги, инференс, контекстное окно, векторы, веса, параметры — за что мне всё это? А, вот ещё: «градиентный спуск», прекрасно. А ведь я просто хочу поставить нейросеть на свой ноутбук. Неужели я много прошу?
Нет смысла превращать бытовую задачу в изучение технических тонкостей: для учёного, преподавателя, юриста или бригадира строителей важен результат, а не устройство системы.
Нейросеть для учителя, адвоката и бухгалтера
Выгода от локальной нейросети видна в любой профессии:
Учитель составляет планы уроков и проверочные. Готовиться к урокам можно и в электричке, и в классе без Wi-Fi: нейросеть работает без интернета, модель крутится на ноутбуке.
Адвокат разбирает договоры клиента. Текст договора не покидает компьютер: конфиденциальные данные не улетают в сеть и не оказываются на чужом сервере.
Бухгалтер сверяет акты и переписку с контрагентами. Платить за подписку не нужно, работа не зависит от тарифов, блокировок аккаунта и доступности сервера.
Посмотрим, чем может быть полезна нейросеть для учителя средней школы. К каждому уроку учитель готовит план, рабочий лист и проверочную работу. Всё это должно сходиться с методическими требованиями, соответствовать учебной программе и ещё десятку разных нормативов. А плюс ко всему 5 «В» немного отстаёт, и надо скорректировать планы ближайших уроков.
Отличная задача для нейросети.
Вот школьный учитель. Он отлично знает свой предмет, но не отличает бэкенд от опенсорса, а кеш от хеша: это слова из чужого мира. Будем справедливы: ведь и не каждый айтишник отличит хиазм от плеоназма, а для учителя русского языка это обычная терминология. Так что обойдёмся без сложной лексики, хотя небольшой словарь всё-таки понадобится.
Терминология для работы с нейросетью
При настройке нейросети на компьютере понадобятся некоторые понятия:
Модель (в нашем разговоре) — это файл размером в несколько гигабайт. Это мозг нейросети. Сам по себе файл ничего не делает: модель заработает в тот момент, когда её запустит внешняя программа. Разные модели созданы разными компаниями: модели GPT делает компания OpenAI, модель Qwen — Alibaba, модель DeepSeek — китайская компания с тем же названием. Дополнительно: у моделей есть версии (разновидности): например, есть GPT-5.6 и есть GPT-6.
Программа для запуска, например LM Studio — это программа-посредник между моделью и человеком. Программа запускает выбранную пользователем модель и предоставляет пользователю окно чата и панель для настроек. Программа и модель — как плеер и музыкальный файл: один плеер играет разные песни.
Чатом мы назовём один разговор с моделью. Всё, что обсуждается в чате, модель помнит только до конца текущего разговора. При разговоре в одном чате модель не знает, о чём шёл разговор в другом.
Промпт — вопрос или задание, которое пользователь отправляет в чат. Системный промпт — постоянное правило (его тоже создаёт пользователь), которому модель следует в каждом чате.
База документов — собственные файлы пользователя, в которых модель ищет ответы. Пользователь сам создаёт базу в отдельной программе.
Облачный сервис, например ChatGPT или Claude, — та же связка модели и программы, только модель работает на сервере компании-производителя, а окно чата пользователь видит в браузере.
Три страха перед домашней нейросетью
Итак, учитель планирует поставить нейросеть на свой ноутбук. И тут появляются опасения.
Нейросеть на моём компьютере начнёт делать что захочет и всё сломает.
Нет, не начнёт. У модели нет доступа к файлам и программам. Пользователь может дать этот доступ, но это уже более глубокая настройка. Худшее, что может случиться, — пользователь получит неверный ответ или нейросеть сильно загрузит компьютер, пока будет размышлять.
Установить нейросеть на компьютер может только айтишник.
Ничего подобного. Установить нейросеть не сложнее, чем любое приложение или игру. Плюс к тому не придётся мучиться с регистрацией: программы бесплатны.
А удалить нейросеть с компьютера можно в любой момент — как обычную программу и обычный файл.
Нейросети работают на мощных серверах, а у меня обычный ноутбук — у него же не хватит мощности!
Скорее всего — мощности хватит. Но стоит посмотреть повнимательнее.
Какой компьютер нужен для локальной нейросети
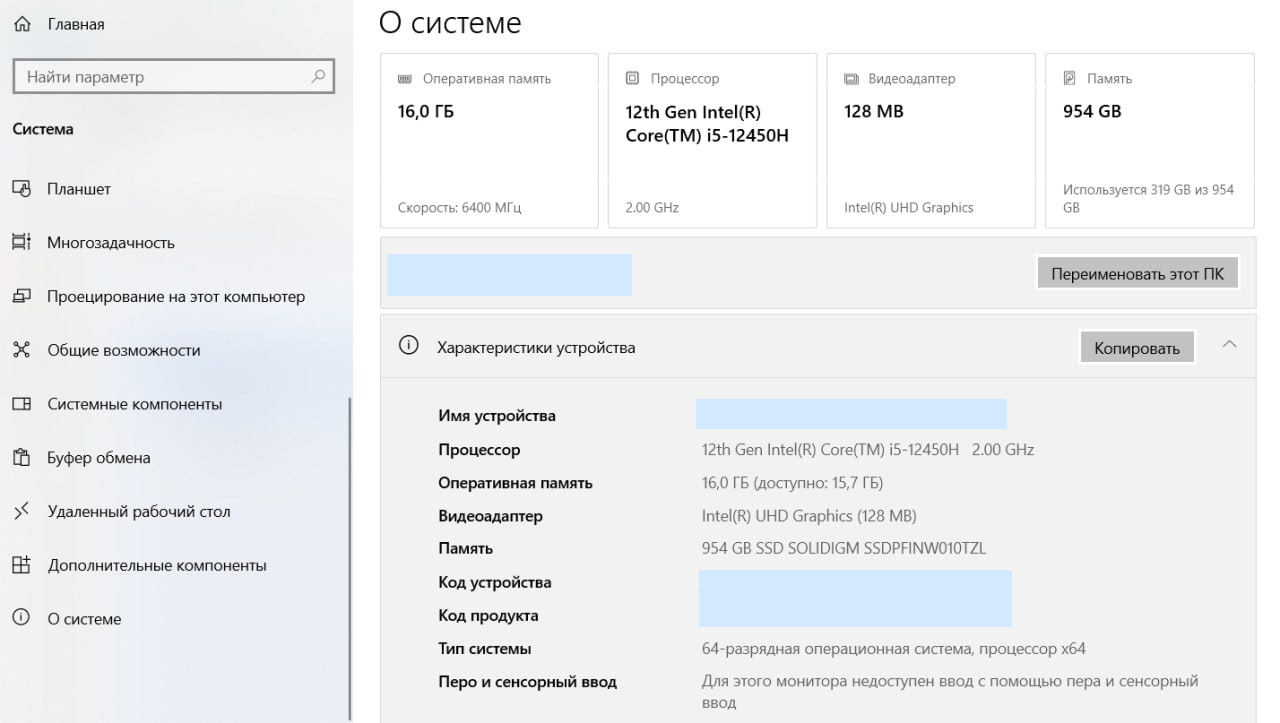
На этом этапе понадобится заглянуть в описание компьютера. Смотрим на оперативную память, видеокарту и процессор.
Для моделей, которые справятся с планами и письмами, минимум такой:
Оперативная память (RAM) — от 16 ГБ.
Память видеокарты — от 8 ГБ, чтобы модель работала быстро. У встроенной видеокарты (Intel UHD, Intel Iris, AMD Radeon Graphics без номера модели) своей памяти нет, и модель работает в оперативной памяти: запустится, но медленно.
Процессор — с поддержкой инструкций AVX2. На Mac нужен процессор Apple серии M.
Проверить компьютер проще всего с помощью нейросети. Сделайте скриншот параметров вашего компьютера, загрузите их в любой чат с нейросетью и спросите: «Потянет ли этот компьютер локальную модель для работы с текстами? Поддерживает ли процессор AVX2? Какую модель выбрать?».
В Windows: откройте «Параметры» → «Система» → «О системе»: там видны процессор и оперативная память. Видеокарту и её память покажет диспетчер задач, вкладка «Производительность» → «Графический процессор». Скриншот делается сочетанием клавиш Win+Shift+S.
На Mac: откройте меню Apple → «Об этом Mac» и нажмите Shift+Command+4.
Перед отправкой запроса обрежьте или закрасьте на скриншоте код продукта, код устройства, серийный номер и любые ключи: это конфиденциальная информация, не отдавайте её чат-боту.
Файл модели довольно велик, и на компьютере должно быть столько свободной памяти, чтобы в неё поместилась вся модель и осталось 1–2 ГБ свободной памяти. Речь идёт о памяти видеокарты (а если карта интегрированная — об оперативной памяти).
Если модель помещается в память видеокарты — нейросеть будет отвечать быстро. Если же нет — работа серьёзно замедлится: вывод абзаца текста потребует полминуты или больше.
Если модель еле ползает, компьютер можно усилить: докупить оперативную память или видеокарту. От оперативной памяти зависит, какую модель компьютер вообще сможет запустить. Видеокарта отвечает за скорость работы: модель, которая целиком поместилась в видеопамять, отвечает в разы быстрее. Оперативная память обойдётся заметно дешевле видеокарты.
Теория закончилась. Идём ставить нейросеть.
Как установить LM Studio
LM Studio — это программа для управления моделями, она ставится как любая другая программа: скачать, запустить установочный файл — и готово.
LM Studio — не единственная в своём роде программа. Например, приложения Jan и GPT4All тоже дают возможность работать с локальными моделями через понятный графический интерфейс.
После установки LM Studio включите «режим разработчика» — так будет проще настроить программу.
надо выбрать и скачать подходящую модель. Прямо в программе есть каталог доступных моделей: там длинный список путаных названий вроде qwen3-8b-Q4_K_M или DeepSeek-R1-0528-Qwen3-8B-Q4_K_M. Выглядит страшно, но сейчас разберёмся.
Какую модель выбрать: что значит 8B и Q4
Если модель подходит для вашего компьютера — в описании модели будет стоять зелёная метка «Full GPU Offload Possible» («Модель можно целиком перенести на видеокарту»). Для скачивания модели просто жмите Download.
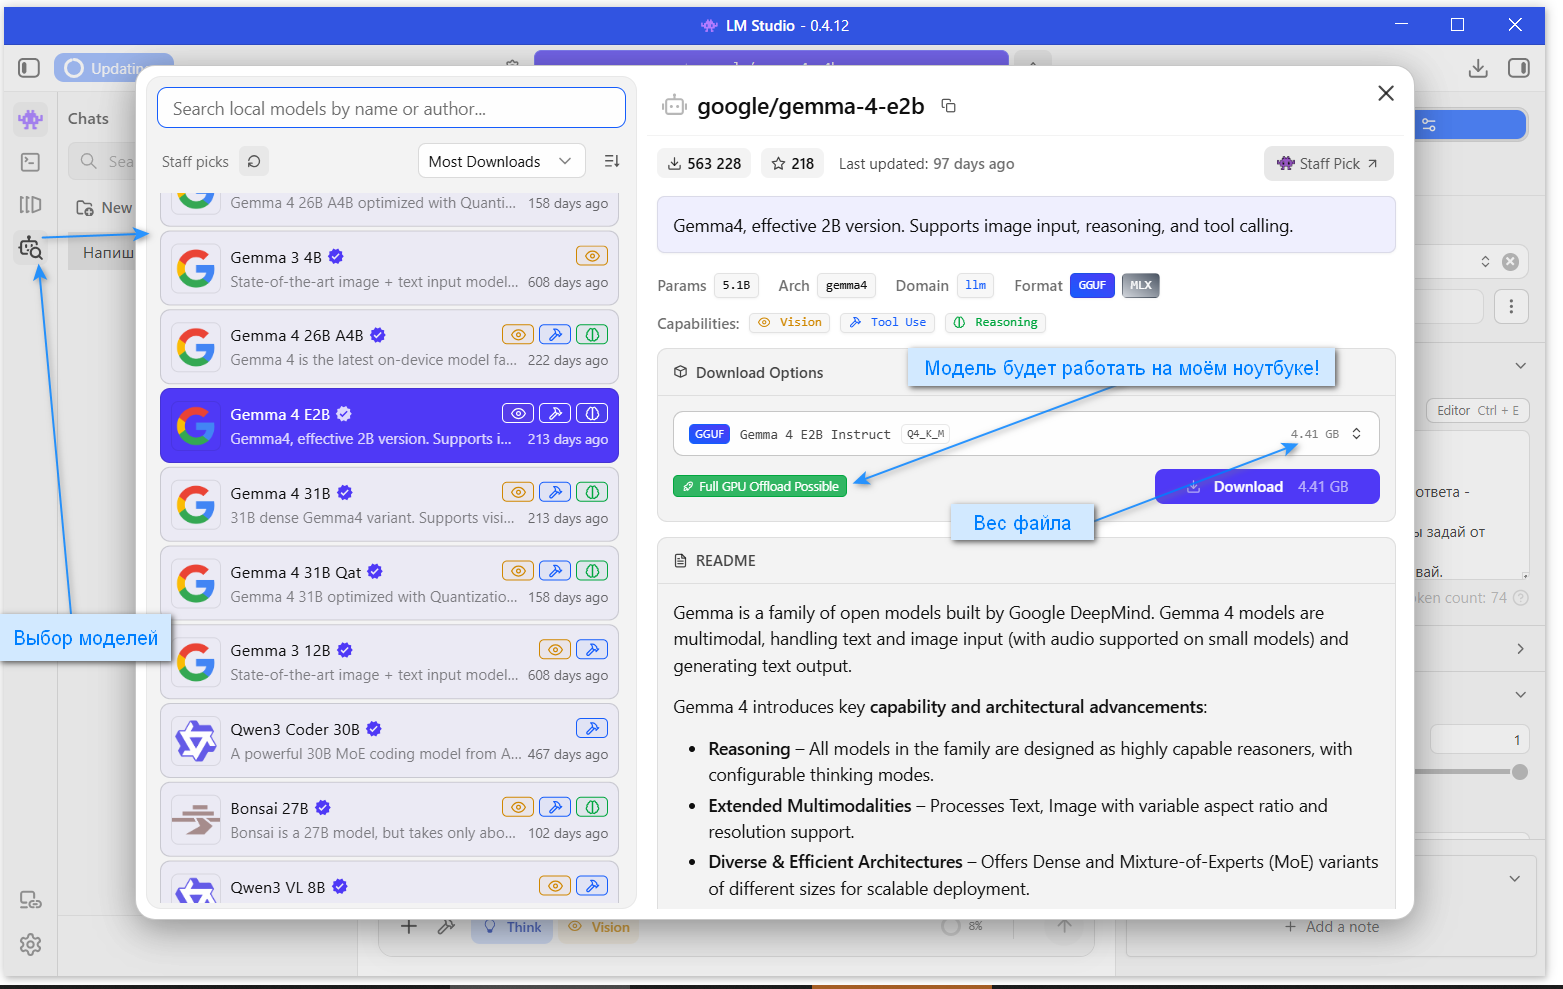
Модель выбираем по двум меткам в названии. Первая — буква B с цифрой (7B, 8B, 14B): это число параметров в миллиардах. Чем больше параметров, тем модель умнее — и тем больше ей нужно памяти.
Владислав Сукманюк, senior-бекенд разработчик/тимлид, наставник курса «LLM-разработчик» в Хекслет
Модели со временем становятся умнее, и небольшая, но новая модель на 8 млрд может быть заметно умнее старой на 14 млрд. При выборе модели обязательно смотрите на «возраст» модели.
Вторая метка — Q4, Q5 или Q8 — это степень сжатия модели. Чем меньше цифра, тем сильнее сжатие и тем меньше файл: Q4 сжимает модель сильнее, чем Q8. Но за сжатие приходится платить: сильно сжатая модель чаще ошибается в деталях. В письмах и планах уроков на Q4 и Q5 разницу почти не будет видно, а на Q2 ответы заметно испортятся.
Разница в размере заметная. Модель на 8 млрд параметров без сжатия весит около 16 ГБ, а в варианте Q4 — около 5 ГБ.
Валентин Исипчук, наставник на курсе «Вайб-кодинг на Claude Code» в Хекслет и практикующий разработчик (Java, Kotlin, Golang, JavaScript/TypeScript)
Для большинства бытовых задач хватает небольшой модели: письма, планы уроков, типовые документы и пересказы прекрасно получаются у моделей на 7-8 млрд параметров в сжатии Q4 или Q5. Возьмите 2-3 небольшие модели, дайте каждой одну и ту же рабочую задачу и оставьте ту модель, у которой лучше результат.
С русским языком популярные открытые модели обычно справляются: Qwen3 от Alibaba заявляет поддержку больше 100 языков, Gemma 3 от Google — больше 140.
Популярная модель DeepSeek на компьютер не помещается: она весит около 400 ГБ. Есть и «домашние версии DeepSeek» — но это не настоящий DeepSeek: это модели Qwen и Llama, которых доучили на ответах DeepSeek. Они работают, но с оригиналом соотносятся примерно как кавер-версия с исходным исполнением.
Через LM Studio можно загрузить на компьютер несколько моделей и переключаться между ними — например, чтобы поэкспериментировать и выбрать оптимальную для текущей задачи.
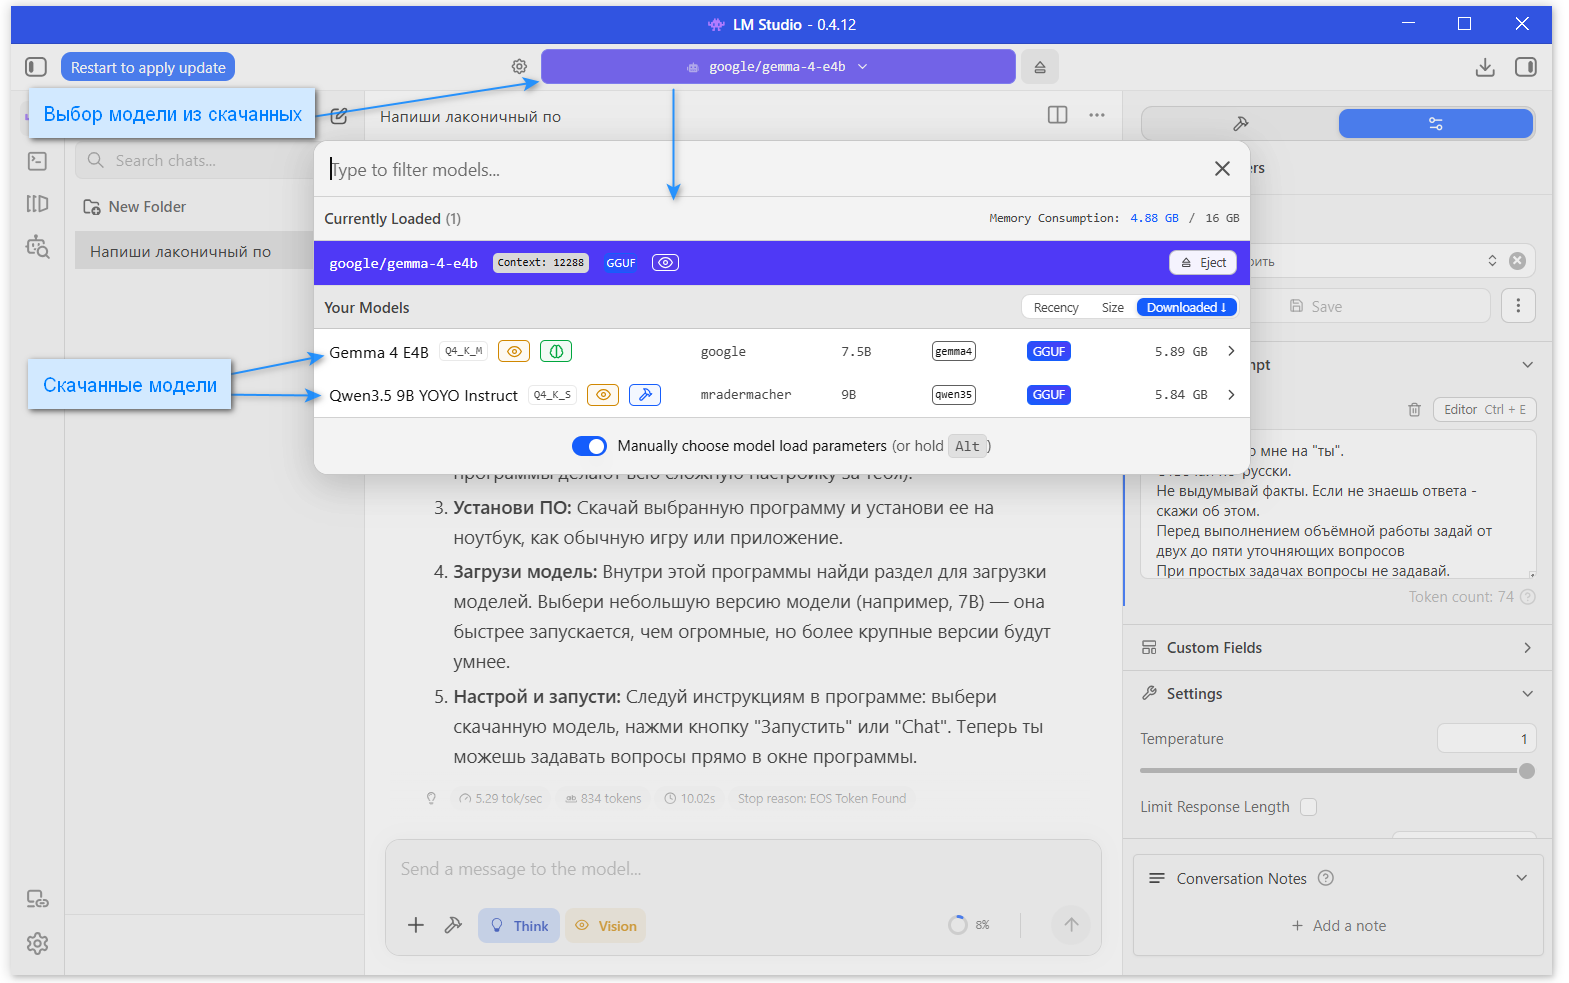
При скачивании и переключении моделей вас ожидает путаница в терминах:
Download model — скачивание модели из интернета на ваш компьютер. Модель большая, скачивание займёт несколько минут.
Load model — подключение модели к LM Studio. Скачанная модель «включается» — загружается в память. Эта операция тоже требует некоторого времени.
Владислав Сукманюк
Я бы рекомендовал сразу настроить Context Length. В LM Studio по умолчанию 4096 токенов: модель сможет запомнить лишь несколько страниц текста, это маловато. Лучше поднять ползунок модели, например до 16 тысяч. Но осторожно: чем больше значение, тем больше нужно памяти.
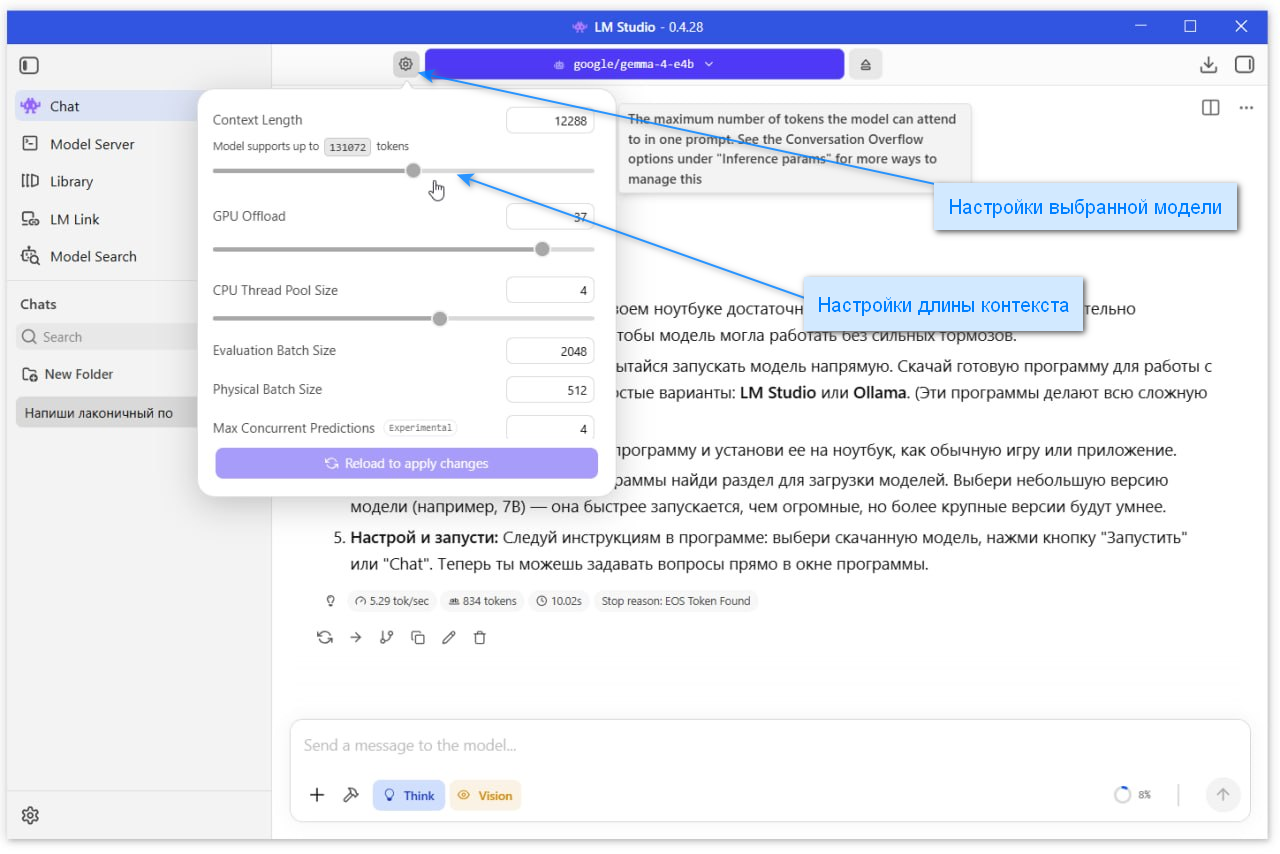
Остальные настройки программы и модели не меняйте: со временем разберётесь и настроите.
Владислав Сукманюк
Перед ответом модель может вывести в чат длинный текст рассуждений. С непривычки можно решить, что программа зависла — но это нормальное поведение для модели. Блок с рассуждениями можно просто свернуть.
Источники знаний модели
Пользоваться моделью можно сразу после скачивания. Но для осознанной работы с нейросетью полезно понимать, откуда она берёт знания:
встроенные знания модель получила при обучении, ещё до скачивания: они «заморожены» на какой-то дате и бывают неточными. Эти знания «лежат» в том самом огромном файле модели;
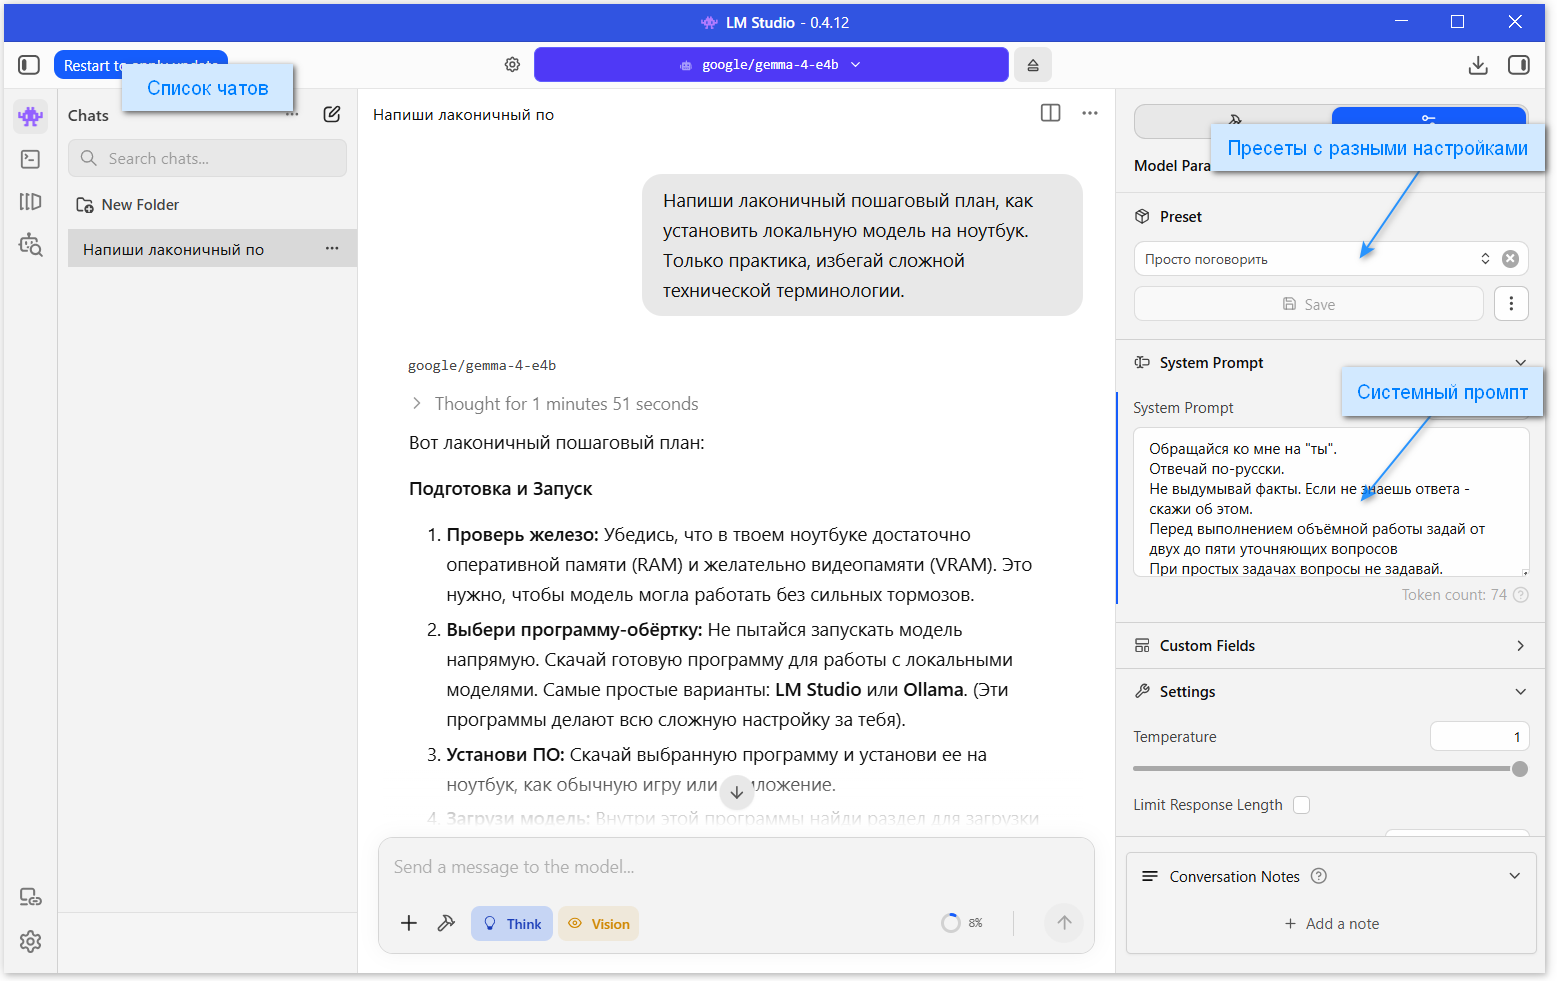
системный промпт — постоянные правила, которые пользователь сам пишет в настройках программы: модель получает их перед каждым разговором;
информация, которую пользователь даёт модели в чате: модель помнит эту информацию только в текущем разговоре;
прикреплённые файлы — собственные документы пользователя, которые он прикрепляет к чату или загружает в базу документов.
Чего у модели нет — так это доступа в интернет. По умолчанию локальная модель в интернет не ходит. При желании можно дать ей доступ в сеть, но на первом этапе это не обязательно.
Есть подход попроще (хоть и требующий ручной работы): нужную страницу сайта можно передать модели или копи-пастом, или сохранить страницу в PDF — и загрузить в чат. Чуть дольше, зато просто и понятно.
Системный промпт: основные правила для модели
Основные инструкции пользователь задаёт в системном промпте: это правило будет действовать в каждом разговоре. Например:
«Отвечай по-русски».
«Ты помощник учителя литературы в 5 классе».
«Если не знаешь ответа, так и скажи. Если не уверен в факте, отметь это».
«Если задача большая, например план урока, проверочная или статья, сначала задай 2–3 уточняющих вопроса. На короткие вопросы отвечай сразу».
«Опирайся на прикреплённые файлы и указывай, из какого файла взят ответ».
Правила стоит проверить на паре задач и при необходимости переписать.
LM Studio сохраняет системный промпт и настройки в пресет — группу настроек. Пресетов можно сделать несколько, например «Уроки», «Статья», «Диссертация» — и переключаться между ними в зависимости от задачи.
Документы: отправка в чат и постоянная база
Для работы над планами уроков надо отдать модели множество материалов, инструкций и методичек. В каждом новом разговоре скармливать в чат ворох одинаковых файлов — занятие неблагодарное. Есть более рациональный подход: создать «склад файлов», специальную библиотеку, к которой нейросеть будет обращаться при необходимости.
На локальном компьютере такую базу создают в отдельной программе, например AnythingLLM: она бесплатная, работает на Windows, macOS и Linux, и все данные, загруженные в базу, хранятся на компьютере.
Как настроить LM Studio и AnythingLLM
Скачайте AnythingLLM, установите. В ходе установки программа скачает несколько дополнительных плагинов, это нормально.
Программы LM Studio и AnythingLLM работают «в связке».
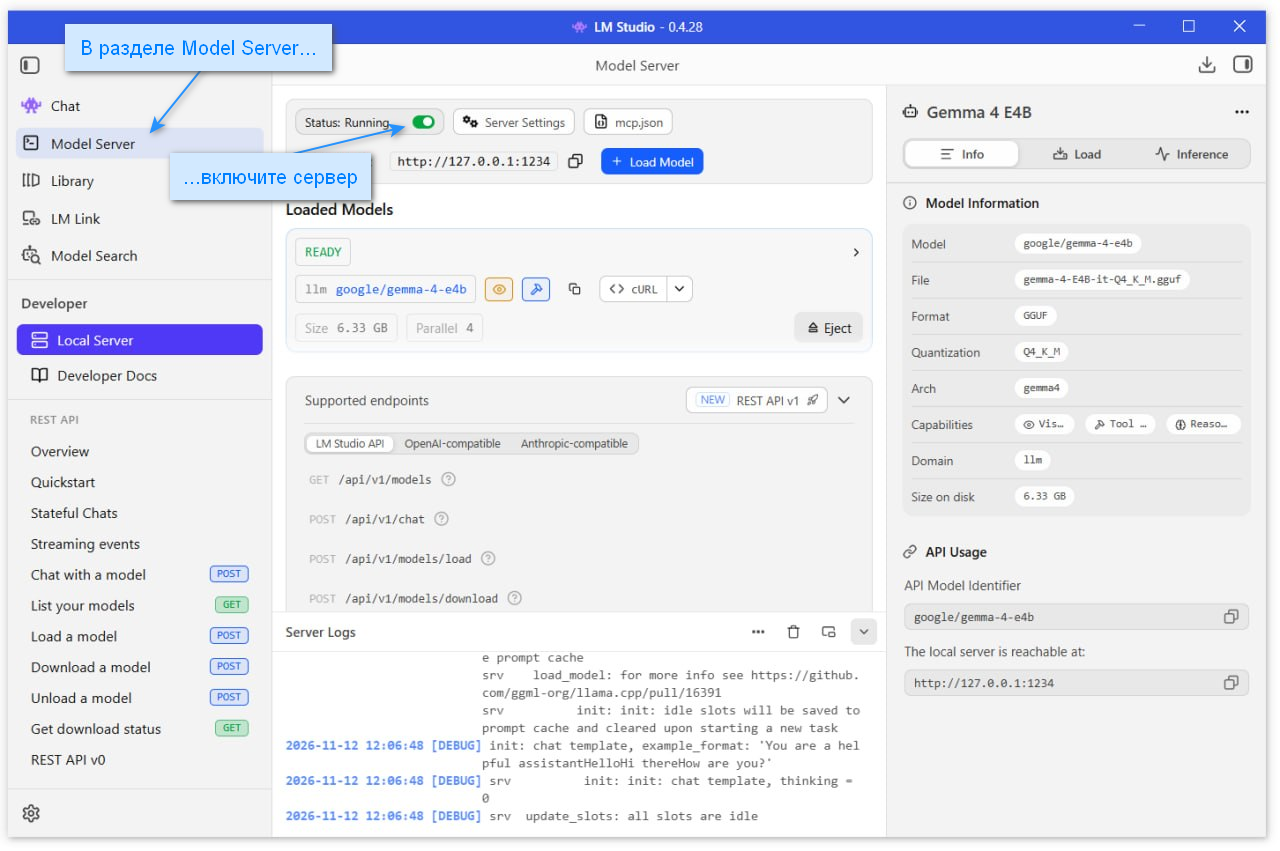
Запустите LM Studio, выберите и загрузите модель. В разделе Model server включите сервер.
После этого откройте AnythingLLM, откройте вкладку выбора модели, выберите «LM Studio» и модель, которую вы загрузили.
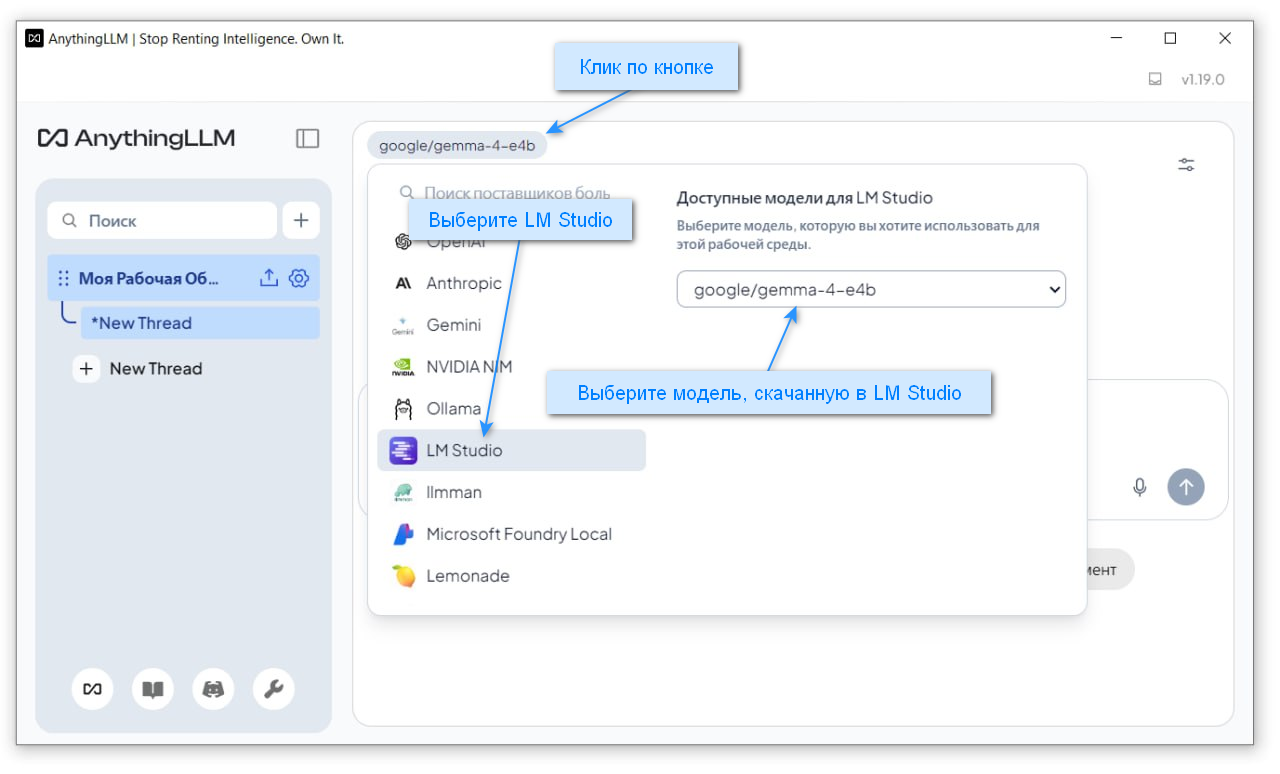
Теперь AnythingLLM будет использовать модель из вашей LM Studio.
Учитель создаёт рабочую область «Литература, 5 класс», один раз загружает в базу программу, методички и конспекты — и каждый новый чат в этой рабочей области получает доступ ко всем документам. Чтобы использовать загруженные документы, нужно вести чаты именно в AnythingLLM.
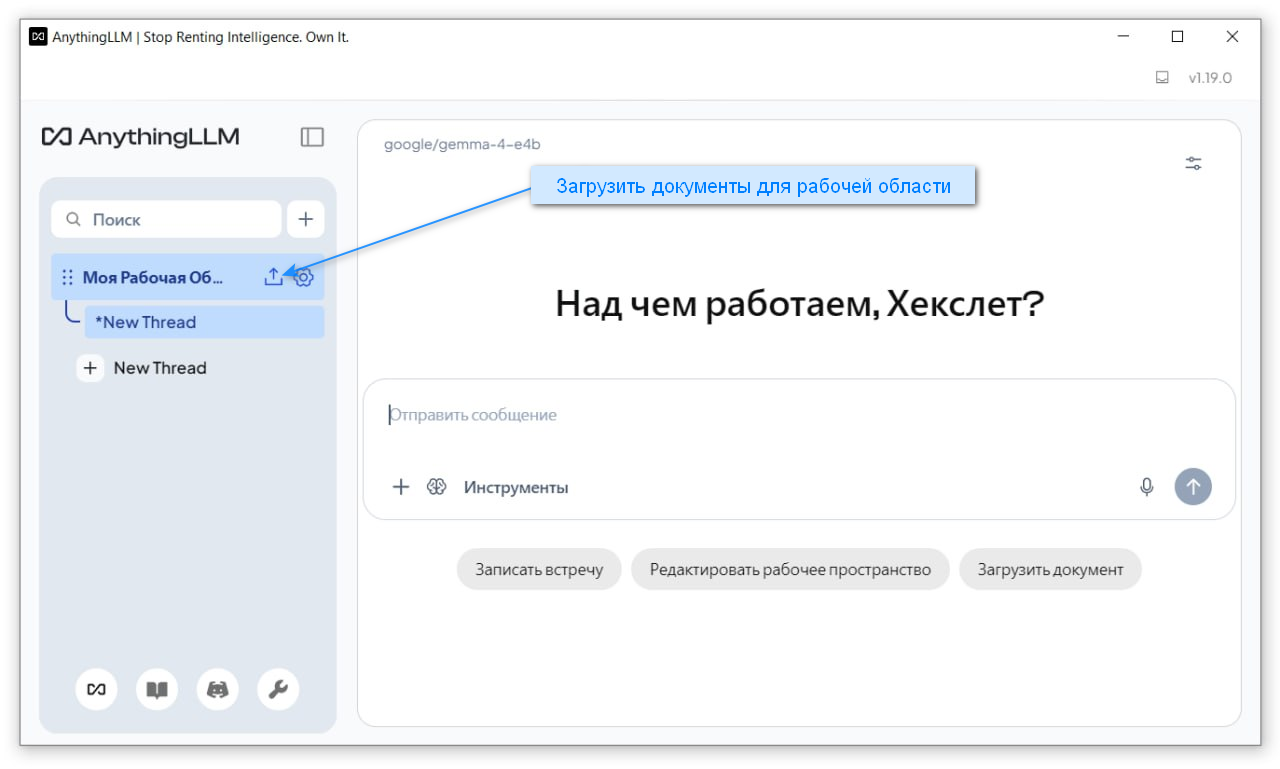
Работа без базового набора документов может обойтись дорого: модель начнёт фантазировать. Предположим, при работе над научной статьёй учитель отправляет в нейросеть несложный промпт: «Кто из методистов писал, что пятиклассники путают мораль басни с её сюжетом?»
Модель отвечает чётко и уверенно. Она укажет автора, название статьи, издание и дату. Но такой статьи может просто не существовать: модель так хотела угодить пользователю, что всё выдумала.
И если такая отсылка попадёт в библиографический список — краснеть за выдуманный источник придётся автору, а не модели.
Это подтверждённое поведение: исследование 2025 года показало, что модель GPT-4o в обзорах литературы выдумала 35 ссылок из 176 — почти каждую пятую.
Чтобы избежать фантазий модели при работе над статьёй, учитель создаёт вторую рабочую область: «Статья про басни». Загружает в эту область пятнадцать исследований — в PDF или любом другом формате. Эти статьи из «КиберЛенинки», информация в них точна и проверена. И теперь модель будет искать ответы только в этих файлах, а AnythingLLM покажет, из какого файла взята цитата. Проверить ответ будет легко: открыть указанный файл, сверить цитату — и готово. Искать по конкретным статьям удобнее, чем перечитывать весь интернет.
Владислав Сукманюк
Корректный поиск по загруженным документам будет работать только в режиме Query («Запрос»). В режиме Chat программа смешивает файлы и собственные знания модели, и в ответы будут просачиваться выдумки. В настройках рабочей области на вкладке «настройки чата» включите режим Query.
Локальная нейросеть или облако
Локальная модель выигрывает, если данные конфиденциальны, облако недоступно или в работе много однотипных задач — планы уроков на четверть, ответы по типовым договорам или сверка актов. Облако нужно для сложных рассуждений, длинных документов или в случае, когда компьютер слабее, чем требуется.
Промпты, постоянные правила и проверка ответов по своим документам одинаково работают и с домашней, и с облачной моделью. Этой работе Хекслет учит на бесплатном курсе «ИИ и нейросети для начинающих»: 12 уроков, около 4 часов, без программирования.
Примеры в курсе даны на облачных моделях в браузере, например в ChatGPT, но принципы работы с нейросетью те же, и их можно сразу применять в LM Studio.
Начните с малого: поставьте LM Studio, скачайте Qwen3 8B в варианте Q4 — и дайте модели рабочую задачу. С настройками можно будет разобраться по ходу работы, а получить рабочий результат можно сразу.
Что ещё почитать
Что такое токены в нейросетях — пригодится, чтобы понять, почему модель может «забыть» часть текущего разговора.
Промпт-инжиниринг больше не главное: что такое инженерия контекста — как лучше настроить модель и дать ей необходимую информацию для работы.
Бесплатные курсы по нейросетям и ИИ в 2026: 23 курса для начинающих и разработчиков. Работе с ИИ можно учиться бесплатно.